emoto-ai
 Fian Alfian
# ========================================================== # EMOTO AI — VERSI LENGKAP # Fitur: # 🎧 Mendengar suara # 🔊 Berbicara # 📸 Membaca teks dari foto # 🎬 Membaca teks dari video # 📚 Membantu belajar # ========================================================== import speech_recognition as sr import pyttsx3 import cv2 import pytesseract from PIL import Image import numpy as np import time import sys # ============== INISIALISASI ============== engine = pyttsx3.init() engine.setProperty('rate', 175) engine.setProperty('volume', 1.0) r = sr.Recognizer() mikrofon = sr.Microphone() # Pengetahuan dasar untuk membantu belajar pengetahuan_belajar = { "matematika": "Matematika itu seperti melatih otot otak. Mulai dari yang mudah, latihan setiap hari sedikit saja, lama-lama pasti makin pintar. Jangan menyerah ya!", "bahasa": "Belajar bahasa itu seperti mengenal dunia baru. Banyak membaca, mendengarkan, dan mencoba berbicara. Kesalahan adalah cara belajar yang terbaik.", "ipa": "Ilmu Pengetahuan Alam menjelaskan bagaimana alam semesta bekerja. Amati, tanyakan, dan cari jawabannya. Semangat peneliti muda!", "ips": "Ilmu Pengetahuan Sosial mengajarkan kita bagaimana hidup bersama, saling menghargai, dan memahami sesama.", "default": "Teruslah bertanya dan belajar, Alfian. Setiap pertanyaan adalah langkah menuju kebijaksanaan. Kalau ada yang sulit, pelan-pelan pasti bisa!" } # ============== FUNGSI BICARA ============== def bicara(teks): print(f"🤖 Emoto: {teks}") engine.say(teks) engine.runAndWait() # ============== FUNGSI DENGAR ============== def dengar(): with mikrofon as sumber: print("🎤 Sedang mendengarkan...") r.adjust_for_ambient_noise(sumber, duration=0.5) audio = r.listen(sumber) try: print("⏳ Sedang memproses...") hasil = r.recognize_google(audio, language="id-ID") print(f"👤 Kamu: {hasil}") return hasil.lower() except sr.UnknownValueError: return "tidak terdengar" except sr.RequestError: return "koneksi bermasalah" # ============== BACA TEKS DARI FOTO ============== def baca_foto(alamat_file): print(f"📸 Membaca foto: {alamat_file}") try: gambar = Image.open(alamat_file) teks = pytesseract.image_to_string(gambar, lang='ind') if teks.strip() == "": return "Maaf, aku tidak menemukan teks di foto itu." return f"Isi teks di foto: {teks}" except Exception as e: return f"Maaf, ada masalah saat membaca foto: {str(e)}" # ============== BACA TEKS DARI VIDEO ============== def baca_video(alamat_file): print(f"🎬 Membaca file video: {alamat_file}") try: video = cv2.VideoCapture(alamat_file) berhasil, bingkai = video.read() if berhasil: bingkai_rgb = cv2.cvtColor(bingkai, cv2.COLOR_BGR2RGB) gambar = Image.fromarray(bingkai_rgb) teks = pytesseract.image_to_string(gambar, lang='ind') video.release() if teks.strip() == "": return "Aku sudah lihat satu bagian dari videonya, tapi belum menemukan teks yang jelas." return f"Aku membaca di videomu: {teks}" else: return "Maaf, aku tidak bisa membuka file videonya." except Exception as e: return f"Maaf, ada masalah saat membaca video: {str(e)}" # ============== BANTU BELAJAR ============== def bantu_belajar(pertanyaan): pertanyaan = pertanyaan.lower() for topik, jawaban in pengetahuan_belajar.items(): if topik in pertanyaan: return jawaban return pengetahuan_belajar["default"] # ============== MENU UTAMA ============== def tampilkan_menu(): print("\n" + "="*50) print(" 🤖 EMOTO AI — MENU UTAMA") print("="*50) print(" 1 🎧 Bicara dan bertanya lewat suara") print(" 2 📸 Baca teks dari foto") print(" 3 🎬 Baca teks dari file video") print(" 4 📚 Minta bantuan belajar") print(" 5 ❌ Keluar dari Emoto") print("="*50) # ============== PROGRAM BERJALAN ============== bicara("Halo! Aku Emoto, teman pintarmu! Siap membantu kapan saja!") while True: tampilkan_menu() pilihan = input("\nPilih nomor menu yang kamu mau: ") if pilihan == "1": bicara("Silakan, aku mendengarkan!") ucapan = dengar() if ucapan != "tidak terdengar" and ucapan != "koneksi bermasalah": if "siapa kamu" in ucapan or "siapa kau" in ucapan: bicara("Aku Emoto, teman buatanmu yang siap membantu dan menemani kamu setiap hari!") elif "terima kasih" in ucapan: bicara("Sama-sama! Aku senang bisa membantu kamu!") elif "siapa namamu" in ucapan: bicara("Namaku Emoto, dan aku bangga jadi temanmu, Alfian!") else: bicara(f"Kamu berkata: {ucapan}. Ada yang bisa kubantu lebih lanjut?") else: bicara("Maaf, aku belum mendengar dengan jelas. Coba lagi ya.") elif pilihan == "2": nama_foto = input("Masukkan nama file fotomu: ") hasil = baca_foto(nama_foto) print(hasil) bicara(hasil) elif pilihan == "3": nama_video = input("Masukkan nama file videomu: ") hasil = baca_video(nama_video) print(hasil) bicara(hasil) elif pilihan == "4": topik = input("Apa yang ingin kamu pelajari hari ini? ") jawab = bantu_belajar(topik) print(f"\n📚 {jawab}") bicara(jawab) elif pilihan == "5": bicara("Sampai jumpa, Alfian! Semangat terus ya, aku selalu siap di sini kapan pun kamu butuh. Selamat beraktivitas!") print("\n👋 Terima kasih sudah menggunakan Emoto AI!") break else: bicara("Pilihan belum tersedia, coba pilih nomor 1 sampai 5 ya.") print("❌ Pilihan tidak valid, coba lagi.") # ================= SELESAI =================

Comments (0)
Sign in to leave a comment
Architecture
No Services Diagrams Yet
Emoto AI
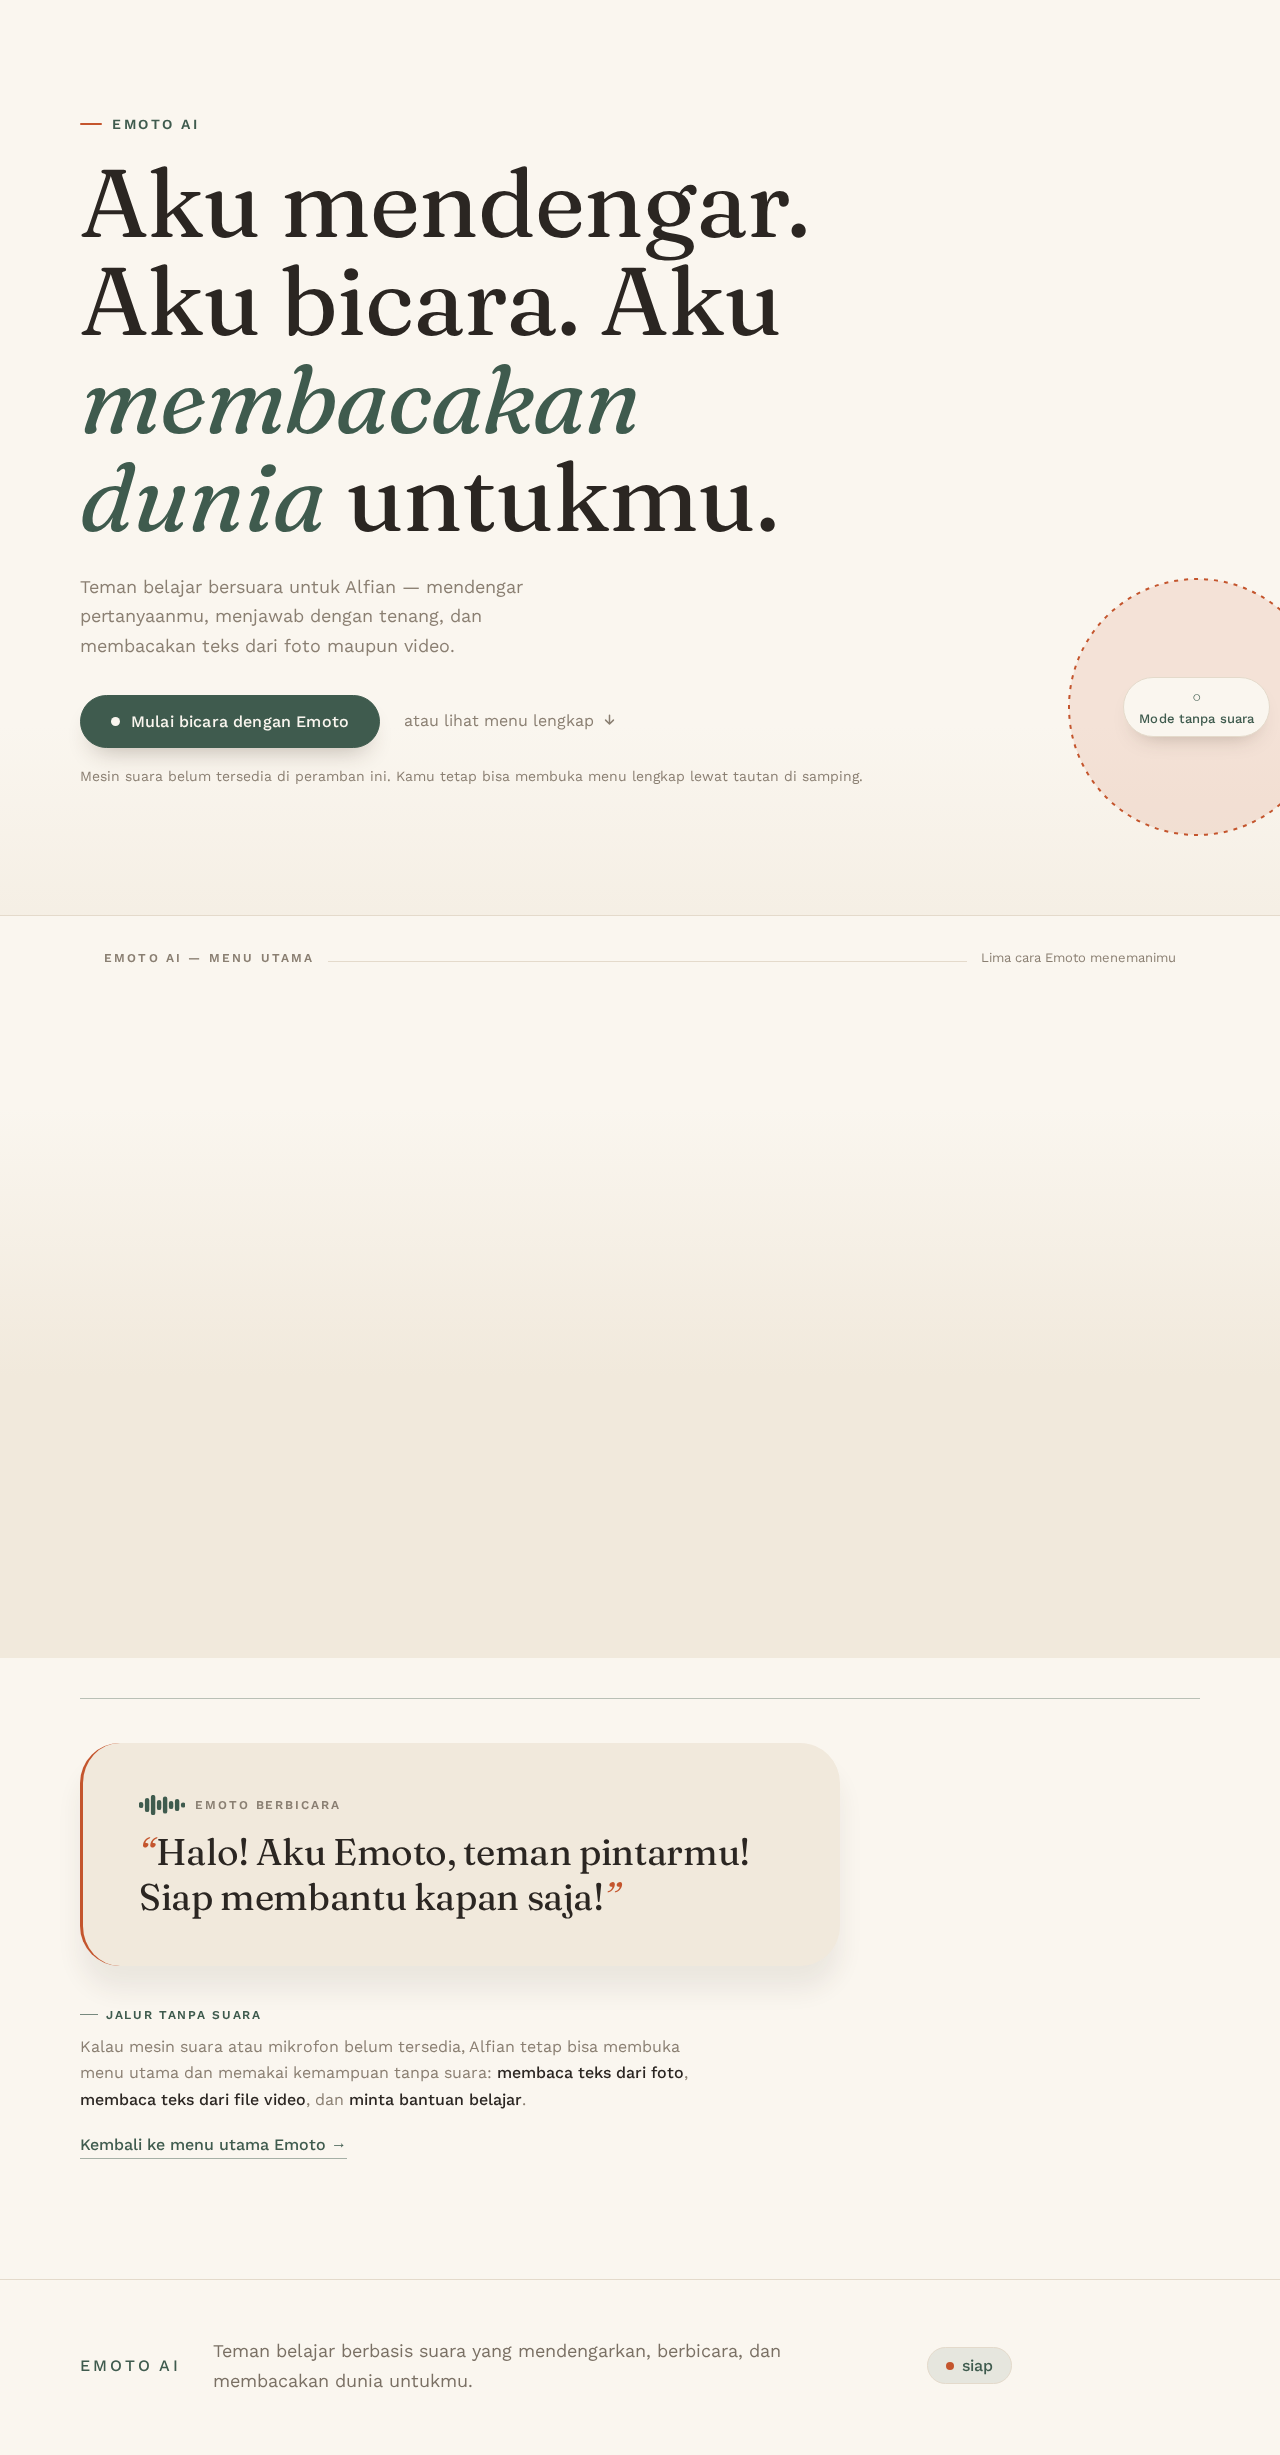
Aku mendengar. Aku bicara. Aku membacakan dunia untukmu.
Teman belajar bersuara untuk Alfian — mendengar pertanyaanmu, menjawab dengan tenang, dan membacakan teks dari foto maupun video.
- Bicara dan bertanya lewat suaraBerbicara dengan Emoto lewat mikrofon dan mendengar jawabannya.siap
- Baca teks dari fotoEmoto membaca teks Indonesia dari sebuah foto.butuh file
- Baca teks dari file videoEmoto membaca teks dari satu bingkai video.butuh file
- Minta bantuan belajarEmoto memberi semangat untuk matematika, bahasa, ipa, dan ips.siap
- Keluar dari EmotoAkhiri sesi dan dengar salam perpisahan Emoto.siap
Emoto berbicara“Halo! Aku Emoto, teman pintarmu! Siap membantu kapan saja!”
Kalau mesin suara atau mikrofon belum tersedia, Alfian tetap bisa membuka menu utama dan memakai kemampuan tanpa suara: membaca teks dari foto, membaca teks dari file video, dan minta bantuan belajar.
No comments yet. Be the first!